Reakcja zaczyna się przed incydentem
NIST SP 800-61 Revision 3 opisuje reagowanie w powiązaniu z całym zarządzaniem ryzykiem. Przygotowanie obejmuje działania Govern, Identify i Protect, właściwy cykl incydentu obejmuje Detect, Respond i Recover, a wnioski powinny wracać do ciągłego doskonalenia.
To ważna zmiana perspektywy: zespół nie powinien dopiero podczas awarii ustalać, kto ma prawo odłączyć system, gdzie są logi, jak skontaktować się z dostawcą i które usługi są krytyczne.
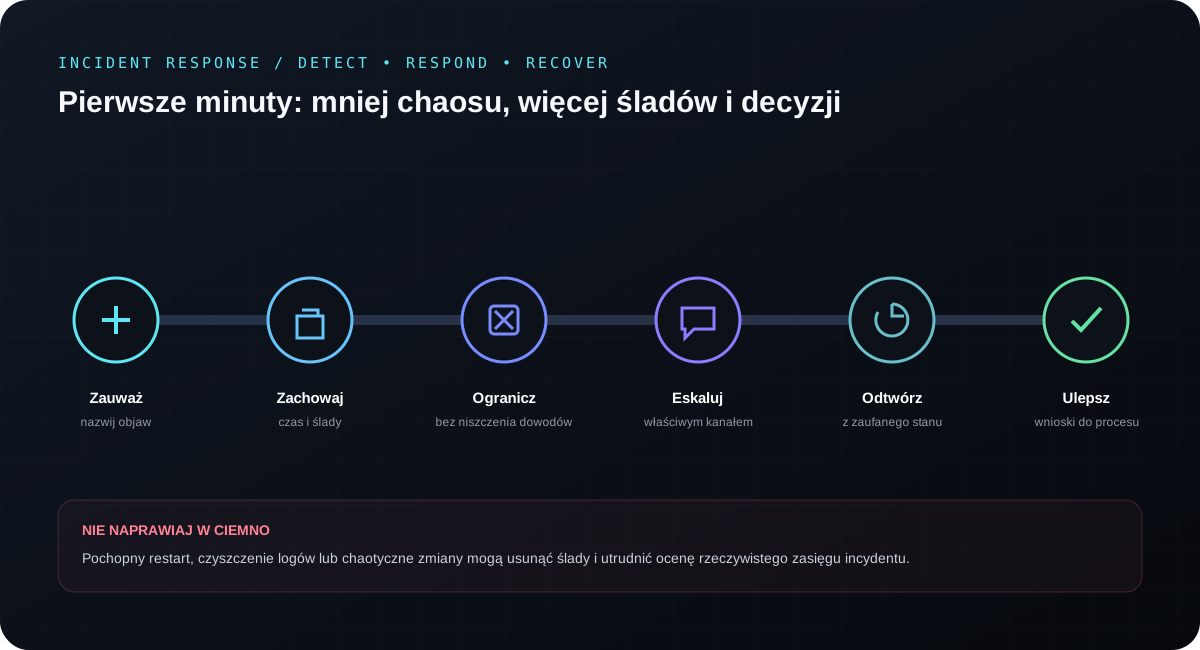
Pierwsze minuty — kolejność działania
1. Nazwij objaw, nie przyczynę
Zapisz, co faktycznie widać: alert EDR, nietypowe logowanie, zaszyfrowany plik, brak dostępności usługi, nieznany proces lub zgłoszenie użytkownika. „Mamy ransomware” jest hipotezą, dopóki dowody jej nie potwierdzą.
2. Zapisz czas i kontekst
Godzina, urządzenie, konto, ekran, komunikat i czynności wykonane przed wykryciem pozwalają później połączyć zdarzenia. Zachowaj identyfikatory alertów, nagłówki wiadomości, nazwy plików i dostępne logi zgodnie z procedurą.
3. Ogranicz skutki proporcjonalnie
Izolacja stacji roboczej może być właściwa przy podejrzeniu aktywnego malware, ale odłączenie całej usługi biznesowej bez oceny może stworzyć większą szkodę. Decyzja powinna uwzględniać krytyczność, możliwość ruchu bocznego, dostępność dowodów i plan ciągłości.
4. Eskaluj właściwym kanałem
Incydentu nie należy omawiać na potencjalnie przejętym koncie lub komunikatorze. Uruchom ustalony kanał awaryjny i podaj krótki stan: objaw, czas, zakres znany na tę chwilę, podjęte czynności oraz potrzebna decyzja.
5. Oddziel powstrzymanie od odtwarzania
Usunięcie pojedynczego pliku nie oznacza zamknięcia incydentu. Najpierw trzeba zrozumieć wektor, zasięg i mechanizm trwałości, a dopiero potem odtwarzać system ze stanu uznanego za zaufany.
Czego nie robić w ciemno
- nie czyścić logów, historii ani plików tymczasowych bez decyzji osoby prowadzącej;
- nie wykonywać wielu restartów „na próbę”;
- nie kontaktować napastnika ani nie odpowiadać na żądania samodzielnie;
- nie przesyłać próbek i danych przez prywatne, niezatwierdzone kanały;
- nie ogłaszać przyczyny ani skali, zanim nie zostaną potwierdzone;
- nie przywracać systemu do sieci tylko dlatego, że objaw zniknął.
Trzy typowe scenariusze
Podejrzane logowanie do konta
Sprawdź zdarzenia uwierzytelnienia, lokalizację, urządzenie i aktywne sesje. W razie potwierdzenia unieważnij sesje i tokeny, zabezpiecz metody odzyskiwania, wymuś zmianę hasła oraz przeanalizuj pocztę, aplikacje OAuth i działania wykonane z konta.
Uruchomienie podejrzanego pliku
Zapisz nazwę, źródło i czas. Nie usuwaj wiadomości będącej wektorem. Zgodnie z procedurą ogranicz łączność urządzenia, zachowaj telemetrię i sprawdź, czy podobny artefakt pojawił się na innych stacjach.
Niedostępność publicznej usługi
Oddziel awarię od ataku. Zbierz metryki obciążenia, błędy, ruch i zmiany wdrożeniowe. Przy podejrzeniu DoS/DDoS uruchom dostawcę łącza lub ochrony, zachowaj próbki ruchu i dbaj o komunikację z odbiorcami.
Co musi być przygotowane wcześniej
- lista właścicieli systemów i kontaktów awaryjnych;
- alternatywny kanał komunikacji;
- retencja oraz synchronizacja czasu logów;
- uprawnienia do izolacji kont, urządzeń i usług;
- kopia zapasowa sprawdzona przez realne odtworzenie;
- kryteria eskalacji prawnej, regulacyjnej i biznesowej;
- gotowe formularze krótkiego raportu sytuacyjnego;
- ćwiczenia obejmujące decyzje, nie tylko techniczne komendy.
Po incydencie należy ustalić nie tylko „kto kliknął” albo „który serwer zawiódł”, ale dlaczego system obrony nie przerwał łańcucha wcześniej. Wnioski powinny prowadzić do zmian technicznych, proceduralnych i organizacyjnych.
Źródła
- NIST — Incident Response i SP 800-61 Revision 3
- NIST Cybersecurity Framework 2.0
- CERT Polska — Zgłoś incydent
- CISA — Incident Response
Stan źródeł zweryfikowany 12.09.2026. Artykuł ma charakter edukacyjny; konkretna reakcja zależy od środowiska, wymagań prawnych i obowiązującej procedury.