Łańcuch dostaw jest częścią powierzchni ataku
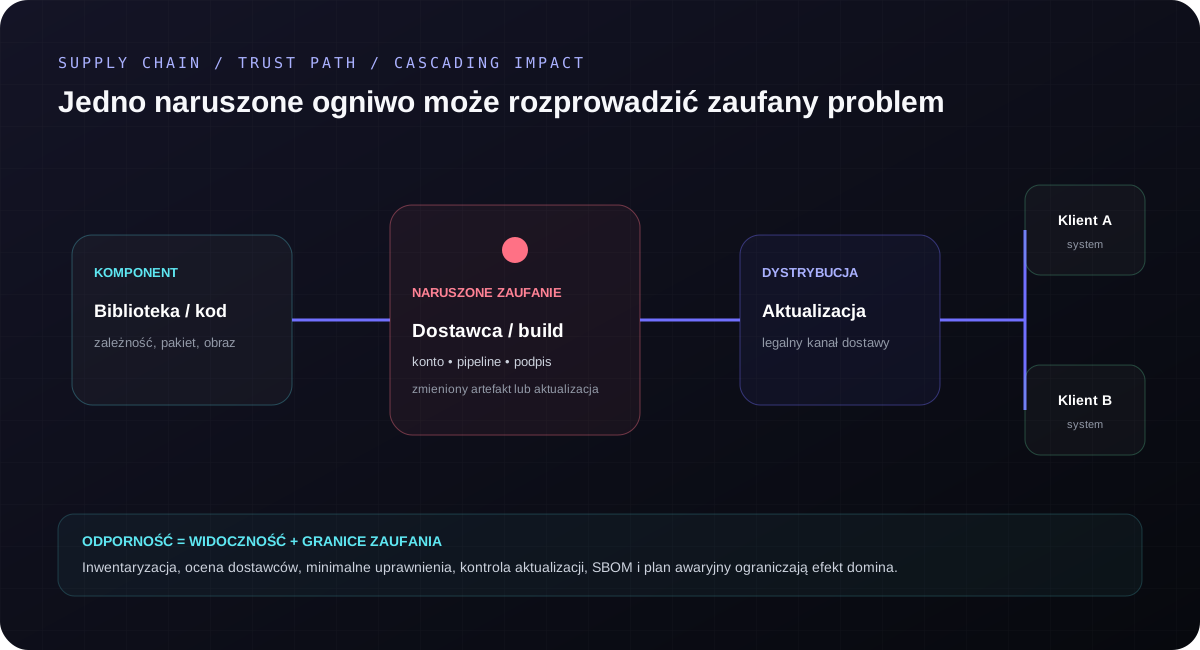
CISA opisuje atak na łańcuch dostaw oprogramowania jako sytuację, w której napastnik narusza środowisko dostawcy i wprowadza złośliwy kod przed dostarczeniem produktu klientom. Problem może trafić do organizacji razem z nowym programem, poprawką lub aktualizacją.
Szerszy łańcuch obejmuje producentów, biblioteki open source, integratorów, usługi chmurowe, MSP, systemy zdalnego dostępu, repozytoria, proces budowania i mechanizmy podpisywania. Każdy z tych elementów może otrzymać uprzywilejowany dostęp albo stać się punktem dystrybucji.
Najczęstsze drogi kompromitacji
Przejęcie procesu aktualizacji
Złośliwa zmiana może zostać rozprowadzona kanałem, który urządzenia i administratorzy uznają za prawidłowy. Podpis cyfrowy pomaga potwierdzić pochodzenie i integralność, ale przejęcie systemu podpisywania lub procesu budowania może podważyć także tę kontrolę.
Zależność open source
Ryzyko obejmuje złośliwe pakiety, typosquatting nazw, przejęte konto maintenera oraz podatność w legalnym komponencie. Ta sama zależność może być obecna w wielu produktach, choć organizacja nigdy nie instalowała jej bezpośrednio.
Konto dostawcy lub narzędzie zdalnego dostępu
Partner serwisowy może mieć połączenie do wielu klientów. Brak izolacji, nadmierne uprawnienia lub przejęte konto tworzą ścieżkę, która omija część zabezpieczeń brzegowych.
Sprzęt, firmware i obraz bazowy
Łańcuch nie kończy się na kodzie aplikacji. Ryzyko może powstać w obrazie systemu, firmware, urządzeniu dostarczonym przez pośrednika albo podczas wycofywania nośnika bez skutecznego usunięcia danych.
Dlaczego taki atak jest trudny do wykrycia
- ruch pochodzi z dozwolonej aplikacji lub znanej infrastruktury;
- proces działa z wysokimi uprawnieniami wymaganymi przez produkt;
- aktualizacja może być podpisana lub dostarczona prawidłowym kanałem;
- ten sam komponent jest ukryty pod wieloma warstwami zależności;
- klient nie kontroluje całego procesu wytwarzania dostawcy;
- naruszenie może dotyczyć tylko wybranych odbiorców po szerokiej dystrybucji.
ENISA zwraca uwagę, że zarządzanie ryzykiem łańcucha wymaga podejścia obejmującego ocenę ryzyka, relację z dostawcą, obsługę podatności oraz jakość produktów i praktyk bezpieczeństwa.
Przykład: zaufana aktualizacja o nietypowym zachowaniu
Organizacja używa narzędzia do zarządzania stacjami. Produkt regularnie łączy się z serwerem producenta i posiada szerokie uprawnienia. Po legalnie wyglądającej aktualizacji proces zaczyna komunikować się z nową domeną oraz uruchamiać polecenia poza normalnym profilem.
Samo zablokowanie domeny może ograniczyć skutek, ale nie odpowiada na pytania: które hosty otrzymały aktualizację, czy kod wykonał dodatkowe działania, jakie poświadczenia były dostępne i czy mechanizm aktualizacji nadal jest zaufany.
Warstwy ograniczające efekt domina
Wiedza o składnikach i dostawcach
- inwentaryzacja krytycznego oprogramowania, usług i połączeń;
- wskazanie właściciela każdej istotnej relacji z dostawcą;
- SBOM lub równoważna widoczność komponentów tam, gdzie jest możliwa;
- rejestr kont serwisowych, certyfikatów i kanałów aktualizacji.
Granice dostępu
- minimalne uprawnienia zamiast domyślnego dostępu administracyjnego;
- wydzielone konta i MFA dla dostawców;
- okna serwisowe, akceptacja połączeń i pełne logowanie;
- segmentacja ograniczająca ruch do zasobów rzeczywiście potrzebnych.
Ocena dostawcy
- wymagania dotyczące zgłaszania incydentów i podatności;
- zasady bezpiecznego rozwoju, podpisywania i publikowania aktualizacji;
- terminy informacji o naruszeniu oraz kontakty awaryjne;
- plan zakończenia usługi, usunięcia dostępu i migracji danych.
Monitoring zachowania
Zaufany proces nadal powinien mieć oczekiwany profil: określone domeny, porty, częstotliwość połączeń i operacje. Odchylenie od tego profilu może być ważniejsze niż nazwa producenta na pliku.
Kiedy dostawca zgłasza naruszenie
- ustal dokładne produkty, wersje, komponenty i przedział czasu;
- zidentyfikuj systemy, które otrzymały artefakt lub korzystały z usługi;
- zabezpiecz logi oraz próbki zgodnie z procedurą;
- ogranicz połączenia i uprawnienia w sposób uwzględniający ciągłość działania;
- sprawdź wtórne działania: nowe konta, zadania, tokeny, ruch i eksfiltrację;
- nie przywracaj zaufania wyłącznie na podstawie ponownej instalacji;
- ustal warunki bezpiecznego powrotu oraz późniejszego monitoringu.